64 个加速器一起保存 checkpoint,如果每个进程只会向存储系统说“写这个文件”,存储层很难发现大家写了相同参数,也不知道哪些节点还有空闲的传输链路。到了推理阶段,多个实例要读同一份模型或 KV Cache,又会遇到类似的问题。
FAST ‘26 的 Fast Cloud Storage for AI Jobs via Grouped I/O API with Transparent Read/Write Optimizations 研究的是让存储系统看见一组操作的整体意图。论文中的 AITURBO 借用空闲主机 DRAM 和加速器通信网络,把数据读写的去重、放置和分发计划从各 AI 框架里挪到存储层。
先看两张网络为什么不一样忙
论文所在的云集群里,一组加速器既连着存储服务器,也有用于彼此通信的高速计算网络。前者要承担许多作业的文件读写,后者往往按更高的带宽需求建设。受测环境中,一台计算节点的存储网卡为 100 Gbps,论文所列计算侧互联为 200 Gbps;这些是实验集群配置,不是所有 AI 集群的标准值。
可以把 AITURBO 的读路径理解成:数据先从存储服务器取到某些计算节点的 DRAM,再通过原有的计算网络向需要它的加速器转发。多个加速器需要同一块数据时,没有必要每个实例都重新穿过存储网络去拿一份。
存储服务器 ──存储网络──→ 节点 A 的空闲 DRAM
                              │
                              └─计算网络─→ 需要相同数据的 XPU 组

控制面:job controller 规划来源、落点与转发路径
数据面:各节点依照计划传输,不逐块经过控制器
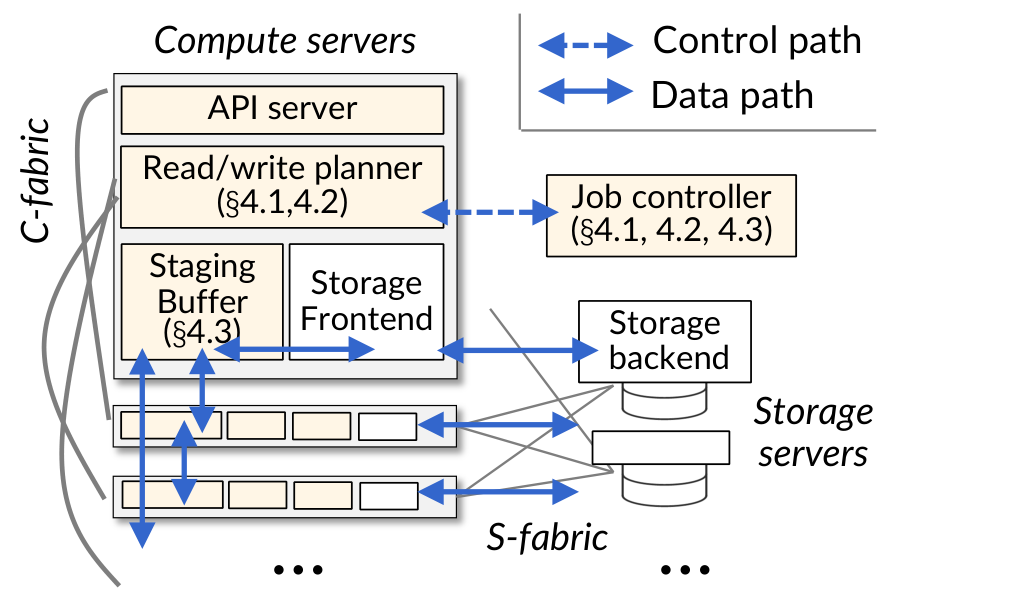
论文图 8:计算节点内的读写规划器和缓冲区,与计算网络、存储网络协同传输。截图来自 AITURBO 官方 PDF 第 7 页,版权归原作者。
这里的“借路”有前提:计算网络必须有余量,缓冲区也得可用。论文指出某些推荐模型推理工作负载可能把主机 DRAM 用满,AITURBO 因而瞄准的是具备可用资源的 AI 任务,而不是白白创造了新的物理带宽。
Grouped I/O 把哪些知识交给了存储层
普通 getfile/putfile 一次只表达一个客户端要读写什么。Grouped I/O API 让应用同时给出参与者集合和一组文件读写操作。控制器因此能看到哪些内容重复、哪些源节点最适合发送、各存储链路能承受多少流量。
写 checkpoint 时,流程分三步:客户端计算块校验和,控制器辨认跨节点重复内容;选取并行、负载较均衡的路径,把需要写的数据放进节点 DRAM;再在需要持久化时刷到后端。读一组共享文件时,反过来尽量只从存储取一份,再通过计算网络向其他消费者转发;若另一节点已经缓存了需要的数据,还可以直接从那里的 DRAM 读取。读写两段数据流可流水线重叠,避免数据全到齐才开始下一段。
为什么不能只让训练框架挑一个 rank 0 写盘?假设多个节点各有相同的参数,统一让一台节点写确实去重了,但那个节点的网卡和写缓冲会变成新的热点。AITURBO 让客户端提交各块校验和与元数据,再在控制器里同时考虑源节点、目标节点的带宽和暂存容量;即使数据只写一次,也能把传输分摊到多条链路。训练的组和张量结构通常会在多个 checkpoint 间保持稳定,控制器还可复用先前的去重元数据与计划,减少每轮重复协调。
从算法角度看,目标并不是“让每条网线利用率一样”,而是缩短最后一块数据完成的时间。某条链路不参与传输,有时恰恰说明把任务再切给它并不能缩短总完成时间。这解释了为什么论文除了使用更快的网络,还投入不少篇幅讨论读写计划与负载均衡。
一个容易混淆的细节是写完成语义。接口提供两个完成事件:future_0 表示数据已进入带副本的主机 DRAM 缓冲区,future_1 才表示后端已持久化。训练任务可以在允许的故障模型下先等前者、继续计算;但如果快照不能丢,必须等持久化完成。系统用多份 DRAM 副本降低风险,仍不能把“内存接收成功”写成“磁盘保存成功”。这也是读 checkpoint 加速数字与写 checkpoint 加速数字不能脱离业务语义比较的原因。
如果在 future_0 完成之后、future_1 完成之前,存放全部副本的节点同时故障,系统会把对应文件标成损坏,应用仍要能回退到可用的上一个 checkpoint。另一方面,若某场景本来就要求每一步都持久化,论文的暂存阶段可以跳过,性能收益也要按相应路径重新评估。“写快”与“在这个故障窗口内仍可恢复”必须同时陈述。
三类负载,三种不同的收益来源
作者在两类加速器集群上测试,最多 64 个 XPU:训练 checkpoint 写入与读取体现群组 I/O 的重复消除和数据计划;模型扩容体现已缓存在 DRAM 的文件如何分发;KV Cache 读取则是单独的推理场景。
| 受测负载 | 论文报告 | 有效的解释 |
|---|---|---|
| 训练 checkpoint 写入 | 相对通用云存储 SFSTURBO,受测配置快 3.9~58.8 倍;对实现了部分优化的 Gemini 最高快 5.9 倍 | 复用空闲 DRAM、计算网络,并对组内重复块去重;不能把缓冲确认当作持久化确认 |
| 模型 checkpoint 分发 | 已有缓存时,64 XPU 部署 Qwen-72B 最快约 2.25 秒 | 缓存已热与必须重新读后端,是不同测试情形 |
| KV Cache 读取 | Qwen-14B、8 XPU、30 分钟轨迹上,平均 TTFT 下降 23% | 比较的是替换 Mooncake 的慢存储后端,未给推理实例启用群组 API |
KV Cache 这一行特别容易被误读。作者评估的 Mooncake 版本在内存缓存未命中后读取存储数据,不会把读回的数据重新填进那层缓存;当重用距离变长、访问落到后端时,存储网络压力上升。将后端换成 AITURBO 后,较快的数据通路改善了 TTFT。论文明确说这一组推理实验没有用 grouped API:动态运行的实例不容易像一次训练作业那样提前组队。收益来自更好的后端读路径,而不是一次“批量 KV 命中”的神奇优化。
AITURBO 已在作者的生产云用于训练任务的 checkpoint;撰文时推理支持还在推进。它擅长 GB 级连续传输、组内重复、可利用的计算网络和暂存 DRAM。没有共享内容的小 I/O、主机内存已满,或者计算网络本身被训练通信打满时,论文的优势条件就不成立。读这种“系统快几十倍”的结果,先问清加速的是哪条关键路径,以及等的是哪个完成事件。
工程成本也有数据:论文统计,在其对照实现里,Megatron 原有的加速 checkpoint 代码约 2,228 行,而接入 AITURBO 额外修改约 286 行;推理 KV 测试替换 Mooncake 后端约改动 44 行。这不是“零侵入”,只是把相当一部分优化放到了统一存储层。群组控制器本身也需要协调;作者在最大 64 XPU 的受测训练配置中量到最高约 45 毫秒的协调开销,对大块数据可摊薄,对频繁的小 I/O 则未必划算。部分对照系统由作者重建或适配,复核倍数时还要确认它们实现的版本与参数。