聊到第 20 轮时,同一个用户的前 19 轮对话还得给模型看。如果历史 KV 已经从显存移走,每轮都从头做 prefill 很浪费;可就算把 KV 存到了主机内存和 SSD,下一轮读它回来仍可能让 GPU 干等。Bidaw: Enhancing Key-Value Caching for Interactive LLM Serving via Bidirectional Computation–Storage Awareness 要解决的,正是“有缓存,端到端服务却不够快”的问题。
这篇 FAST ‘26 论文同时改计算侧的请求调度、存储侧的淘汰决策,以及缓存张量的选择。下面沿着一次用户再次提问的路径看它怎样工作。
为什么仅仅缓存 KV 不够
多轮对话的 KV 会随轮数和并发用户一起增长。作者的交互式对话负载中,平均每位用户有 22.4 轮;如果每轮重算之前的历史,冗余计算最高可占总计算量的 93.1%。所以不能简单地说“SSD 慢,不如每轮重算”。
但缓存也不是免费的。论文采用 GPU 显存之外的两层存储:主机 DRAM 是性能层,SSD 是容量层。当历史 KV 总量超过主机内存,部分请求必须先从 SSD 升到 DRAM,再进 GPU。实验机器的 SSD 阵列带宽约 1.5 GB/s,明显慢于 CPU 到 GPU 的传输;请求排错队,GPU 就可能因一份很大的历史 KV 在 SSD 上而闲着。作者将现有两级缓存方案与“所有 KV 都在主机 DRAM”的模拟上界对照,发现前者在其负载下的响应延迟最多高出 3.8 倍。这里的上界是假设能装下全部历史的对照,不是作者真的给服务器加了无限内存。
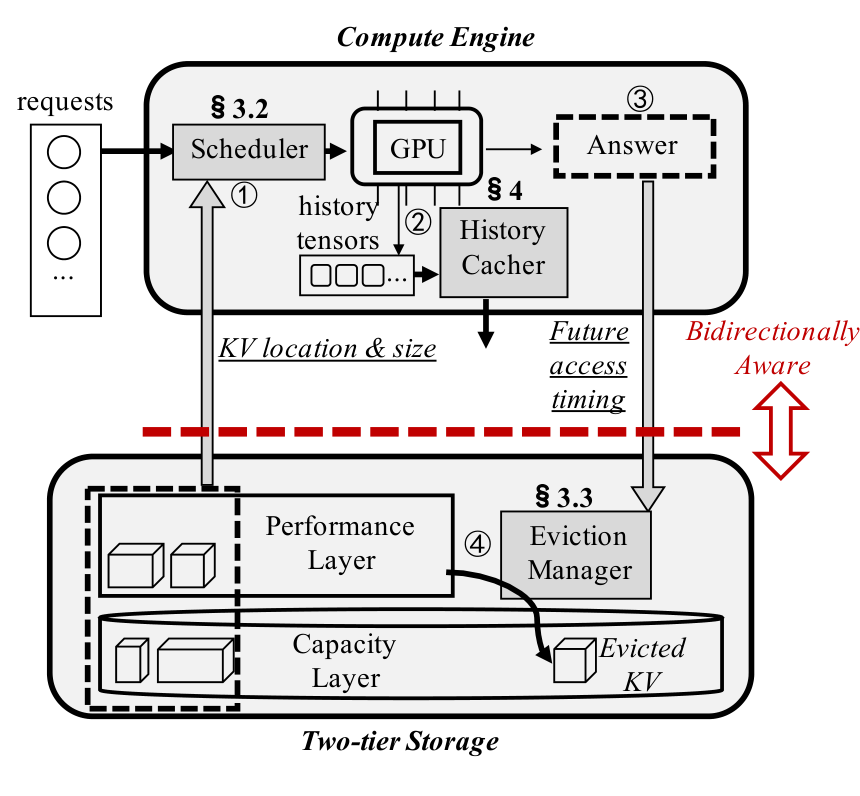
论文图 9:计算引擎根据 KV 所在层安排请求,两级存储分别承接性能和容量需求。截图来自 Bidaw 官方 PDF 第 6 页,版权归原作者。
计算侧:把“能算”和“正在搬”分开
设想三个请求依次到达:A 的历史 KV 在 SSD,B 和 C 的 KV 已在 DRAM。直接按到达顺序计算,A 的慢读取会堵住 B、C。Bidaw 的两个队列把“是否就绪”和“何时到达”分开处理:
请求 A ─ KV 在 SSD  ─→ 准备队列 ─ SSD→DRAM ─┐
                                               ↓
请求 B ─ KV 在 DRAM ──────────────────────→ 就绪队列 ─→ GPU
请求 C ─ KV 在 DRAM ──────────────────────→ 就绪队列 ─→ GPU
就绪队列按原始请求到达时间调度。A 读完 SSD 晋升时,不会因为晋升晚就失去它原来的排队顺序。准备队列则要安排 SSD 读取次序:先服务较小的 KV,通常能更快准备好一个请求;同时把等待时间算进优先级,避免大 KV 一直饿着。论文把这一策略称作 disk-HRRN,核心直觉是“大小影响读取成本,久等需要补偿”。
为什么不直接把 SSD 读取和 GPU 推理流水线重叠掉?作者给出的限制是:一次计算的迭代会持续多个阶段,而为请求加载慢层 KV 的时间往往是数百毫秒;只与第一轮 GPU 计算重叠,能遮住的时间很有限。双队列处理的是请求级别的队头阻塞。即使 GPU 当前只能容下有限数量的请求,让已经就绪的请求先运行,也比让它们跟在未完成的 SSD 读取后面更容易填满 GPU。
这不是用排序消除 I/O,也不是把所有 SSD 请求无限期让位给内存请求。它改变的是慢 I/O 何时阻塞 GPU 的关键路径。在 OPT-13B、每分钟 30 个新用户的受测设置里,平均计算前排队时间从普通先来先服务的 5.76 秒降至 2.45 秒。
存储侧:刚生成的回答,能帮忙决定淘汰谁
传统 LRU 看的是上一次访问,而人类用户读完回答才继续提问。作者发现,上一轮模型回答越长,下一轮访问历史 KV 之前,系统往往已经处理了越多其他人的请求。
论文用加权复用距离刻画这件事:两次访问同一位用户的 KV 之间,其他不同 KV 的累计大小。打个纯粹说明定义的例子:如果期间只读了另一位用户的 20 MB KV 和第三位用户的 40 MB KV,这次加权距离就是 60 MB。它衡量的是缓存容量压力,不是“用户会在多少秒后回来”。在作者按不同时段采集的 12 组交互负载里,回答长度与这一距离的下界呈较强相关,Spearman 相关系数为 0.94~0.98。
实现上并不是“回答长就逐出”。系统用各用户的历史访问分布估计下一次会落在哪个复用距离区间,再用回答长度推得的下界排除不可能太近的区间。一个后台运行的 ghost cache 在已经发生的旧访问上模拟理想淘汰,用来估计不同距离区间的命中潜力;结合两者,为每位用户算下一次访问的命中概率,优先逐出潜力最低的 KV。ghost cache 不知道真实未来,因此这里仍是预测而非离线最优算法在线运行。
两级缓存采用包含关系:SSD 保有副本,DRAM 淘汰时通常不必把同一份大张量重新写盘。对受测 OPT-13B 设置,这一淘汰策略相对论文比较的队列增强策略,主机内存未命中率最多降低 57.6%。
第三个细节:缓存什么张量
历史对话的 KV 可以避免重算,但 KV 未必是“每节省一单位计算量所需存储字节数”最合算的中间结果。Bidaw 比较了不同中间激活的省下的计算量 ÷ 存储占用:对受测 MHA 模型,一类归一化激活比直接保存最终 KV 更划算。读回来后在 GPU 上补一步计算就能恢复所需 KV,转换被放到低优先级 CUDA stream,尽量利用其他推理没有占满的算力。
这个优化有明确边界。GQA 模型原本保存的 KV 更小,论文认为上述中间张量不再占优,应直接缓存 KV。它是按模型结构选缓存表示,而不是声称所有模型的 KV 都能按同一比例压缩。
实现还有一个不起眼的传输细节:小粒度的 PagedAttention 页有利于减少显存浪费,但把历史 KV 从主机内存传到 GPU 时,过于零碎的拷贝不利于用满 PCIe。Bidaw 把长度已知的历史与用户输入放进更大的 256-token 块,正在生成、长度未知的回复仍使用 16-token 小块;两种块可以拆分、合并,避免把“读得快”换成大量显存碎片。缓存张量的选择、主机到 GPU 的搬运粒度和请求调度,是同一条数据路径上的不同问题。
实验数字怎么拆开读
论文在单张 80 GB A800、200 GB 主机内存、四块 SATA SSD 组成的阵列上测试 OPT 和 Qwen 模型。与 vLLM、作者重建的 CachedAttention/FlashGen 等基线比较,结果包括作者自己的真实时序交互负载,以及没有原始时间戳、需要模拟请求到达时间的公开 ShareGPT 负载。
| 论文中的观察 | 对应条件 | 应怎样理解 |
|---|---|---|
| 响应延迟最多改善 3.58 倍、可承受用户到达率最多提高 1.83 倍 | 多模型、作者交互负载;与受测方案比较 | 是该实验范围的端到端上限,不等于每次请求都快 3.58 倍 |
| 排队时间 5.76 秒 → 2.45 秒 | OPT-13B,每分钟 30 位新用户 | 主要检验双队列调度有没有减少计算前等待 |
| 主机层未命中率最多降低 57.6% | OPT-13B;相对队列增强淘汰策略 | 主要检验模型回答信号能否改善 DRAM 留存 |
| ShareGPT 上可承受用户到达率提高约 1.40 倍 | 与 FlashGen 在相近平均延迟下比较 | 公开轨迹的到达时间是模拟的,不能直接支持“回答越长越晚回来” |
最后一行尤其值得注意:作者明确说,由于 ShareGPT 不含真实时间戳,给它补的泊松到达时间没有让回答长度驱动的淘汰进一步降低未命中率。这说明端到端收益既来自调度,也依赖对真人交互节奏的观察;不能把自采对话的相关性直接外推到脚本连续提问的 Agent。
消融实验把三个优化逐个加上:在 OPT-30B 设置下,调度单项让平均延迟最多改善 1.58 倍;加入回答感知的淘汰后,同等延迟条件下可承受用户数再提高约 1.25 倍;最后加入更合算的缓存张量,吞吐进一步提高约 1.10 倍。它们不是三次针对同一个指标的独立测速,因此不能简单相乘。尾延迟也没有被平均值掩盖:受测 OPT-30B 上,P99 相对 CachedAttention 下降约 47%。
还有两个复现前提。第一,对照中的 CachedAttention 和 FlashGen 当时并不开源,作者是在 vLLM 上重建其主要机制,不是拿两个官方实现开箱跑分。第二,核心测量来自单张 GPU、受限主机内存和 SATA SSD 阵列。更多 GPU 并行后,CPU/GPU 链路竞争、SSD 共享及会话分片都会改写瓶颈,需要重新量而不是照抄提升倍数。更适合带回服务系统的判断是:先量请求究竟卡在重算、SSD 晋升,还是就绪队列;只有这些成本同时可见,两级 KV 缓存的命中率才有完整意义。