Agent 调用完一次工具,下一次提示词往往只是多了一段工具输出。后面的长期记忆、规则说明一个字没变,却整体向后挪了几十个 token。这一段过去生成的 KV,能直接搬到新位置用吗?
CacheSlide: Unlocking Cross Position-Aware KV Cache Reuse for Accelerating LLM Serving 回答的是一个比“前缀缓存命中没命中”更难的问题:文字相同,位置和前文改变之后,KV 不一定相同。 简单跳过 prefill 可能提升速度,但会破坏注意力,最终改变答案。
“固定片段”不一定待在固定位置
可以用下面这个简化结构理解 Agent 提示词。两轮中的固定片段内容和相对先后顺序没变,但中间动态内容变长了:
第一轮:固定规则 A │ 动态工具结果 1   │ 固定知识 B │ 新问题
第二轮:固定规则 A │ 更长的动态结果 2 │ 固定知识 B │ 新问题
                                               ↑ B 的绝对位置已变
论文把常见方法分为固定位置复用(PDC)与位置无关复用(PIC),再提出介于两者之间的相对位置依赖复用(RPDC)。区分不在于是否“允许重用一段文本”,而在于能接受怎样的提示词变化:
| 路线 | 可以复用什么 | 主要代价 |
|---|---|---|
| 固定位置复用 PDC | 原位置不变的前缀或预先算好的位置 | 动态内容一插入,后续固定片段就可能错过缓存 |
| 位置无关复用 PIC | 从别的位置取相同片段 | 忽略位置与前文,容易造成 KV 漂移,还需额外重算修正 |
| 相对位置依赖 RPDC | 固定片段绝对位置变化,但相对顺序保持 | 需要识别提示词结构,仍须校正变化片段造成的注意力影响 |
为什么不能干脆把动态内容移到末尾,制造一个大前缀?因为工具结果可能被后续指令引用;调换顺序会改语义和依赖关系。RPDC 不是任意重排的缓存,而是利用 Agent 模板本身保留的顺序。
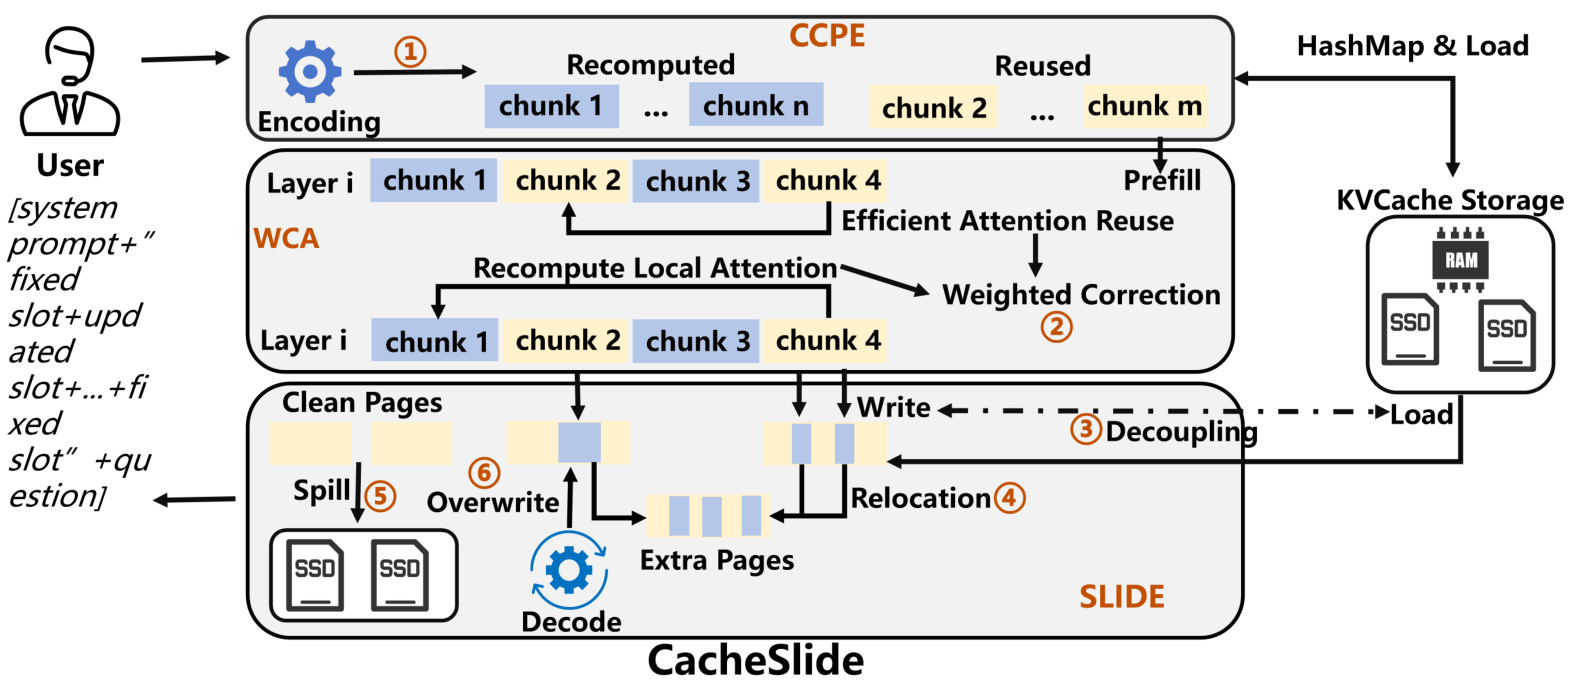
论文图 6:CCPE 处理位置变化,WCA 修正注意力,SLIDE 管理 KV 的写入与加载。截图来自 CacheSlide 官方 PDF 第 7 页,版权归原作者。
先处理位置漂移,再补注意力
第一关是 PMKD,即相同片段在不同位置复用时,缓存 KV 与重新计算的 KV 发生偏移。作者用 CKSim 比较键向量的相似度,观察到在其受控位置移动实验里,传统 RoPE 的相似度随偏移增大明显下滑;低位置敏感度的 CoPE 更稳定。这不是说所有 RoPE 模型都不能缓存,而是在跨位置直接搬运旧 KV 的前提下,位置编码会成为障碍。
CacheSlide 的 CCPE 将提示词按模板切为可复用块与必须重算块,为可复用块学习相对稳定的位置编码范围。这里的“学习”不是可省略的配置项:论文针对任务数据做了继续适配,保留模型主干权重、训练注意力层的 LoRA adapter,以支持 CoPE。之后才有条件让固定块的缓存位置与当前推理时的位置尽量接近。
更细看,它先用同一类任务的提示词学习常见的编码模式,再由 Agent 模板标出哪些块可复用、哪些块必须重算。命中时按块的内容查找旧 KV,重新计算的块使用当前输入的编码。这不是简单为每个 token 统一减去一个偏移:如果只靠给片段前面留一个预估长度的空窗口,动态工具输出超过窗口就会再次错位;窗口留得过大,又会扩大存储和计算负担。论文的窗口填充对照也出现了明显的 F1 退化。
第二关是跨片段注意力。即便固定块彼此相对位置差不多,动态块的内容更新也会影响它们。Weighted Correction Attention(WCA)先在第一层重新计算并比较缓存 KV 和当前 KV 的差异,挑出偏差较大的 token;后续层主要重算这些 token,将新旧结果按权重融合。算法每隔数层检查相似度,必要时调整被重算的集合。换句话说,它没有“零成本缓存整个固定块”:首层比较和后续选定 token 的修正都是真实开销,收益来自避免所有层、所有固定 token反复做全量计算。
挑选依据也有讲究:第一层比较同一 token 的新旧键向量差异,再选偏差较大的 top-k;后续每隔四层检查 CKSim。如果某些原先选中的 token 仍达不到预设的相似度要求,就换入其他更需要修正的位置。作者在其模型与数据集的参数扫描里,正确完成任务的 QPS 在 top-k 约 26%、CKSim 阈值约 0.12 时达到峰值;这两个数是该组实验的调参观察,不能复制成所有 Agent 的默认参数。
也因此,论文谈的是受测任务中低精度损失的近似复用,不是像查同一条字节流那样无条件精确命中。最终该看任务准确率与首 token 延迟(TTFT)的取舍,不能只看复用率。
SSD 页管理为什么和位置编码出现在一篇论文里
WCA 会逐层读取旧 KV、更新一部分 token。若一层必须等旧页从 SSD 载入后才能写新 KV,前面省下的计算时间可能在 I/O 上还回去。CacheSlide 为此设计 SLIDE:当重算比读取更早结束时,先把更新结果写入临时新页,避免写操作卡在旧页的加载上,之后更新页映射并复用可用槽位。
这个小小的“另开一页”解决了加载旧页与写新页争同一位置的问题,但要付出额外页面和索引维护成本。系统在进入后续层前按首层选中 token 的数量准备额外槽位,加载与重算各自推进,之后再按映射关系合并。若旧数据先装完,则可以直接更新原来的槽位;两种顺序都必须保证当前层使用的 KV 版本正确。
内存压力继续增大时,KV 页还要溢出到 SSD。更新过的脏页若频繁写回,会造成零碎写入和写放大。SLIDE 先逐出不需写回的干净页;不得不逐出脏页时,优先把含较多被选 token 的页聚起来写。它把“允许跨位置重用”的算法问题,接到了“这批局部修改怎样不拖慢 SSD”的系统问题上。
数字与复现前提放在一起看
实现基于 vLLM 0.8.5。主要实验使用单张 A100 80 GB,70B 模型改用两张;主机有 500 GB DRAM 和 2 TB NVMe。模型覆盖 Mistral-7B、MPT-30B、Llama-3 70B,任务覆盖多跳问答、多会话记忆和软件修复 Agent。作者不仅量 TTFT,也量答案质量与 SSD 写放大。
| 指标 | 论文报告的范围 | 读法 |
|---|---|---|
| 请求延迟与吞吐 | 延迟改善 3.11~4.3 倍,吞吐提升 3.5~5.8 倍 | 来自不同受测配置,不是单个请求必然同时取得两个上界 |
| SSD 写放大 | 比受测方案降低 3.11~3.62 倍 | 体现脏页感知淘汰,存储压力低时重要性会下降 |
| 答案质量 | 在受测任务中接近重算基线,形成较好的准确率–TTFT 权衡 | “接近”不等于对所有提示词无损,也不是数学上的 KV 等价 |
最需要留意的对照条件是:CacheSlide 运行时启用了适配过的 CoPE,而比较方案保留各自原生的 RoPE/ALiBi;除了缓存管理,它还包含位置编码和模型适配的改动。固定片段相对顺序若经常变化、提示词模板无法稳定切块,或者没有条件训练 adapter,就不能把论文的倍数直接当成原生模型上“一键启用跨位置缓存”的收益。
如果只想复核“存储系统部分到底有没有用”,可以看论文在 SWE-Agent 任务下的写放大消融,以及增加 batch/beam width 后的 TTFT:并发越高、越容易把 KV 推向 SSD,脏页管理的重要性越明显。反过来,若所有 KV 都能常驻内存,SLIDE 防止 SSD 零碎写入的收益自然会减小;这时 CCPE 与 WCA 的计算/质量取舍才是主角。