若 SSD 容量通过 CXL 以类似内存的方式暴露给 CPU,命中设备上的 DRAM 缓存可能不到 1 微秒,落到 NAND 却要几十微秒。普通设备模拟器如果让每次访存都发生 VM-exit,模拟器自己的开销便已超过真实设备的快路径。此时拿它比较缓存算法,结论可能是错的。
FAST ‘26 论文 Cylon: Fast and Accurate Full-System Emulation of CXL-SSDs 针对的不是“把普通 SSD 变成 CXL 内存”,而是构建一套能运行未修改操作系统与应用的研究工具。它在 QEMU/KVM 中暴露 CXL Type-3 设备,用 FEMU 模拟 SSD 的闪存与 FTL 时序,再用快慢分流避免虚拟化开销掩盖设备特征。
对 CPU 来说,看到的到底是什么
来宾系统可以把设备视作 DAX 区域,或者一个不带 CPU 的 NUMA 节点。应用通过 load/store 读写地址,而不是向传统 NVMe 块设备发一次文件读取。来宾看得到的容量对应模拟的 SSD;中间还有一块设备自己管理的 DRAM 缓存,应用通常不用手动把热页放进去。
一份地址是否命中缓存,决定它下一步走哪条完全不同的路:
来宾 load/store → EPT 页表项
                  ├─ Direct:映到宿主 DRAM 缓存 → 直接完成
                  └─ Trap:触发 KVM 陷入
                            → QEMU/FEMU 模拟 NAND、填充缓存
                            → 更新 EPT,下次命中走 Direct
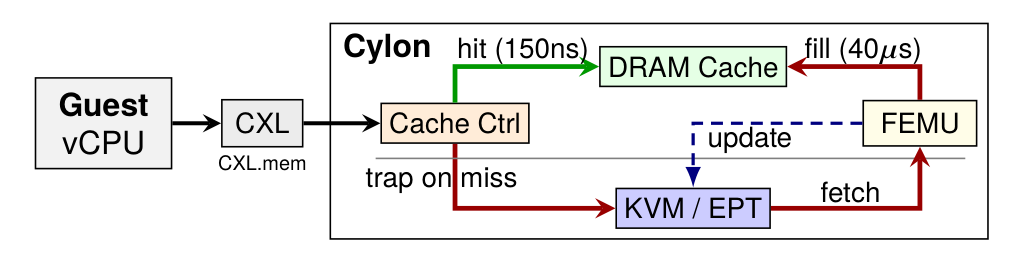
论文图 1:缓存命中直接访问 DRAM,未命中则经 KVM/EPT 陷入并交给 FEMU。截图来自 Cylon 官方 PDF 第 5 页,版权归原作者。
EPT 是硬件辅助虚拟化中的二级地址转换。Cylon 将已缓存页面的 EPT 项标记为可直接访问;未缓存的页故意设成不可读写,以便第一次访问时陷入处理。缓存填入、干净页逐出与脏页写回,都需要正确更新 EPT 项并使陈旧的地址翻译失效,否则来宾可能访问已经换成别的数据的缓存页。脏页被逐出时要先交给 FEMU 写回,不能只改映射就声称具备持久化语义。
作者进一步让用户态模拟逻辑与 KVM 共享受控的页表项区域,减少每次缓存状态变化都走 ioctl 和页表查找的成本。这个共享并不是允许用户态随意映射任意物理地址:论文描述了受限的缓存区间、允许的页表状态和缓存状态转换。快路径走硬件映射,慢路径留下必要的软件控制,是它既能跑全系统又不把亚微秒命中模拟成十几微秒的关键。
还有一个不能忽略的正确性细节:修改 EPT 后,CPU 可能还握有先前的地址翻译。Cylon 在填充和逐出后做相应的 EPT/TLB 失效,并把相邻发生的变化批量处理,避免每换一页都做一次全局清空。否则,虚拟机以为页已逐出,CPU 却继续从旧物理地址读数据;模拟出来的高命中率也就毫无意义。设计一条不陷入的快路径,必须同时保证缓存状态翻转时的慢路径是对的。
量“模拟器开销”,先把 NAND 延迟拿掉
论文的微基准刻意将 NAND 延迟设为零,并分别固定 100% 缓存命中与 0% 命中。这是在单独量模拟机制的成本,不能把数值直接当作真实 SSD 的访问延迟:
| 微基准情形 | 访问延迟 | 它量的是什么 |
|---|---|---|
| Cylon,全部命中 | 约 0.16 微秒 | 命中后经宿主远端 NUMA DRAM 直通的开销 |
| 普通 QEMU CXL 路径 | 约 14.74 微秒 | 每次访问陷入模拟器的路径成本 |
| Cylon,全部缺失,优化后 | 约 16.27 微秒 | NAND 延迟为零时的处理、FTL 与页表更新成本 |
| Cylon,全部缺失,较早实现 | 约 23.04 微秒 | 尚需额外 ioctl 等往返的缺失路径 |
缺失路径本来就比命中慢,再叠加论文用于其他实验的 NAND 读取约 40 微秒,快慢两级的差距才符合研究目标。论文不是用“16.27 微秒缺失”宣称真实闪存也只要这么久。
SSD 的读、写、擦除也不能用同一个延迟常数代替:作者在受测模拟设置里分别给了约 40、200、2,000 微秒的基础时序,同时交给 FEMU 的 FTL 处理映射与垃圾回收,因此竞争、缓存缺失与后台管理会影响实际请求的时序。先人为关掉 NAND 延迟量框架自身,再打开 NAND 时序观察真实形态,这是它验证设计的两步,而不是两组可以互换的硬件成绩。
为什么还拿商用原型机跑 Redis
模拟器可能很快,却未必模拟对了。作者找 Samsung CMM-H 原型机校验,并跑 Redis 的纯读负载、GAPBS 图算法;还试验 FIFO、CLOCK、S3FIFO 等缓存淘汰策略与不同预取力度。最关键的对照变量是工作集大小 / 设备 DRAM 缓存大小。因为实验中的模拟器配置为 4.8 GB DRAM 缓存、96 GB SSD 容量,而原型机约为 48 GB 缓存、1 TB 容量,直接拿相同绝对数据集大小对比反而不公平。
随着归一化工作集从“装得进缓存”变成“经常落到 NAND”,Cylon 能重现与硬件类似的性能转折。它也可用来问更具体的问题:在某种跨页步长的访问里,预取后命中率会不会改善?论文中的一组步长为 4096 的微基准,随预取力度从零加到八,命中率从 18% 提高到 86%;随机访问则几乎没有同样收益。这个观察只适用于那组访问模式,不该扩展成“预取越多越好”。
Redis 实验使用纯读的 YCSB 负载和 1 KB 记录,以工作集大小控制缓存压力;图计算则看 GAPBS 的介数中心性计算。前者更容易看出请求级尾延迟和淘汰策略的差异,后者检验随图规模增大时,模型是否还能跟上“多数访问命中 → 缺失增多”的转折。只用平均单次读延迟验证不了这些应用层趋势。
模拟器允许替换 FIFO、CLOCK、S3FIFO 等策略,也提供面向来宾应用的预取、固定与逐出提示。这里隐藏着一个观测难题:快路径绕过模拟器,命中本身不会自动留下完整事件日志。论文提出用 EPT 的 accessed 位周期采样,或用处理器的 PEBS 采样访问;前者覆盖粗,后者更细但有监测开销。比较缓存算法时,采样方式和负载一样需要写进实验条件。
可信范围:哪里像硬件,哪里还只是模型
作者坦言,当前命中延迟基本由宿主远端 NUMA DRAM 决定,约 150 纳秒;其商用原型机带控制器的命中约 800 纳秒。因而小工作集全在缓存时,模拟器可能比原型机更快,虽然跨过缓存容量后的走势接近。Cylon 当前还把模拟的后端 SSD 数据存放在宿主 DRAM,只靠 FEMU 模拟 NAND 时序与管理;可模拟容量因此受宿主内存约束,不等于跑了一块同容量的物理闪存。
这些限制也影响怎样使用论文给出的开源工具:它能运行不改代码的来宾负载,实验若要测试“应用主动提示哪些页该预取”,就需要在来宾端显式调用研究接口;二者不是同一个透明性承诺。它能通过调节策略比较设计,却还不能随意指定一个真实商用控制器的独立命中时延。在决定产品性能之前,应把模拟器的数据转折和目标硬件的绝对延迟分开验证。
所以它很适合用来探索缓存、预取、应用级 prefetch/pin 提示对负载行为的影响;要给某一款设备的精确命中时延或真实闪存失效行为下生产承诺,还得回到目标硬件上测。