只有 8 GB 显存的笔记本,能不能处理 128k token 的历史?模型权重还没算,完整 KV 就已经占了不少空间。把 KV 挪到 SSD 可以解决容量,却不能假装每生成一个 token 时都有足够时间把全量历史搬回 GPU。
FAST ‘26 论文 SolidAttention: Low-Latency SSD-based Serving on Memory-Constrained PCs 的解法,是把动态稀疏注意力与按 SSD 特性安排读写一起设计。只减小 GPU 缓冲区会让 I/O 变成新瓶颈;只减少注意力计算、不改变读取粒度,SSD 同样难以跑快。
一次 decode 实际需要多少历史
完整 KV 占用大致随上下文长度线性增长,也与层数、KV head 数、head 维度和数据精度成正比。GQA 能减少 KV head 数,但 128k 这种长度仍会给本地显存和内存带来压力。对于长上下文注意力,不同历史 token 对当前 query 的作用并不相等;SolidAttention 利用这一点,但不永久丢弃历史 KV。
系统把历史按 token 分块,从每块的 K 中提取代表向量。每层生成新 token 时,开头的 attention sink 块和最近一段的局部块必定保留;中间其他块则按代表向量与当前 query 的相似度,选出 top-k 参与本次注意力。没选中的块仍存在 SSD,后续 query 有需要时还可再读。与在 prefill 结束后一次性删除“冷 token”相比,这能避免未来问题突然需要旧信息时无处可找。
SSD:完整历史 KV ──按层、按块存放──┐
                                   │
当前 query ─→ 选块:开头 + 最近 + 相似度 top-k
                                   │
               预取 / 补读 → GPU 缓冲 → 本层注意力
代价是代表向量并非原始块的完整内容:top-k 选得太少,或者一个代表向量覆盖太多 token,都可能漏掉关键信息。论文用不同块大小的长文本检索测试这一取舍,而不是只报“从 SSD 少读了多少字节”。
这也解释了“动态”和“稀疏”为什么缺一不可:静态稀疏一旦提前删除旧 KV,下一轮选块不可能补救;动态选块则保存所有数据,允许新的 query 改变热点。代价是每层都要存储并遍历较小的块代表,以及为当次真正需要的块付出 I/O。SSD 在这里承担完整历史的容量,GPU/DRAM 只为当前层留下相对有限的工作窗口。
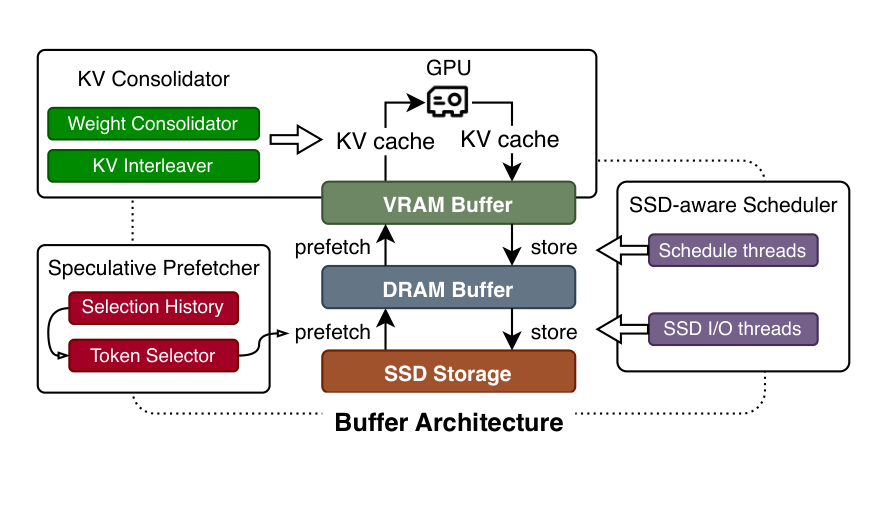
论文图 3:块选择、预测预取和 SSD 感知调度共同管理 SSD、DRAM 与 GPU 间的 KV 数据流。截图来自 SolidAttention 官方 PDF 第 5 页,版权归原作者。
为什么把 K、V 交错放在一起
GPU 读 KV 可以很细,SSD 却更喜欢较大的连续传输。粗暴扩大每块的 token 数,虽然减少 I/O 次数,却会让一个代表向量概括太多内容,长文检索的召回可能下降。
SolidAttention 换了个方向:不增大一块包含的 token 数,只把同一个 token 的 K 和 V 交错排布。 原来分开的 K 读取与 V 读取合成更大的传输单元,在论文设计中约能把请求次数减半。模型初始化时还把生成 K/V 的投影权重预先组织好,让推理过程直接产出需要的布局,避免把整理开销留到每次 decode。CUDA 后端的消融实验里,单独加入这种布局,使注意力阶段延迟最多降低约 22%。
块到底做多大也不是定死的。作者在 SYCL 后端观察到,块从 16 token 增至 32 token,吞吐大约提高 14%,因为单次 I/O 更能利用 SSD;再继续增加时速度逐渐趋于平缓,而块代表覆盖的内容过多会损害检索召回。K/V 交错是改变布局来改善 I/O,扩大块大小是牺牲选取精度换取较粗 I/O,这两种手段不能混为一谈。
不知道下一层要读什么,怎么提前读
稀疏块要等 query 参与评分后才能确定。若此时才从 SSD 加载,GPU 还是要等。作者把开头和局部块当作确定会使用的数据预取;其余块参考上一轮生成中同一层选过的块做预测。预测命中,I/O 可以与计算重叠;预测错误,则在真正选块后补读缺失块,并覆盖无用的预取数据。预测影响性能,不应影响选块后的计算正确性。
调度器再把一层的 query 投影、选块、KV 投影、SSD 读取和注意力计算看成有依赖关系的小任务:query 投影一结束就能选块,缺失块的加载可以与 KV 投影重叠;注意力本身必须等输入齐备,不能为了“并行”读到尚未填好的缓冲区。调度器优先处理会卡住关键路径的任务,并合并不必要的 CPU/GPU 同步。这也解释了系统为什么能在单用户、batch=1 的笔记本上受益,而不要求靠许多并发请求遮盖 SSD 延迟。
缓冲空间紧张时,“预取错了”比在大服务器里更危险:错误预取不仅浪费 SSD 带宽,也可能占掉正确块的落点。论文的策略是等正式选块后加载遗漏的块,并用这些块覆盖没用上的预取页,不要求对整份缓存重新排序。调度层则以任务依赖限制这种覆盖的时机。这些工程细节决定了稀疏选择能否真正以小内存运行,而不是仅在纸面上省掉注意力乘加。
不要混用速度、占用和准确率数字
论文同时评估 NVIDIA RTX 4070 Laptop(8 GB 显存)的 CUDA 后端和 Intel 集成显卡的 SYCL 后端。模型权重采用 INT4,KV 仍为 FP16;限制可用 DRAM 后,主要与“全量 SSD 卸载”及“SSD 卸载+稀疏注意力”等方案比较。
| 测量 | 受测条件 | 论文结果 |
|---|---|---|
| 生成速度 | CUDA、128k 输入,相对 SSD 卸载+稀疏注意力 | Llama-3.2-3B、Llama-3.1-8B、Qwen-2.5-7B 分别最高约 2.8、3.1、2.4 倍 |
| KV 内存占用 | 长上下文;另含 Qwen2.5-14B 的扩展测试 | 最多减少约 98%;这是 KV 占用,不是整机或模型权重减少 98% |
| 预取对阻塞的作用 | 16k 输入的消融实验 | CUDA 上 SSD 缓存加载造成的阻塞延迟最多降低约 3.9 倍,并非整体速度又乘 3.9 |
作者用多个任务评估回答质量,LongBench 的长上下文质量测试最长到约 64k;这支持受测任务上“精度损失较小”,不能自动证明任何 128k 文档都不受稀疏选块影响。此外,把 SSD 作为 KV 主存储,就必须留意它是否还在承担其他 I/O:作者让后台任务占用 4 GB/s 带宽时,系统吞吐下降约 58%。
内存口径同样值得拆开:论文在一种配置下只为单层约 1k token 的 KV保留工作缓冲,观察到三款模型的 KV 内存占用约缩小 62 倍;在更大模型的扩展实验里,又报告最多约 98% 的占用减少。两者说的是 KV 的驻留空间,不是把 SSD、模型权重、代表向量和运行时工作区统统变成原来的 2%。在共享 SSD、CPU 内存也有限的现实机器上,未命中时读取延迟仍是必须测的账。
这套设计的价值是用更少内存换取本地长上下文可用,同时尽量补上 SSD 带来的延迟。显存足够、上下文很短,或 SSD 已被别的任务打满时,决策就可能不同。