一台主机接一块 CXL 内存时,可以盯着延迟和带宽;如果想把主机、加速器、多个内存设备通过交换机连成更大的 fabric,瓶颈可能已经从内存本身变成路由、端口争用和一致性消息。没有对应的现成硬件,怎么比较这些设计?
FAST ‘26 论文 Xerxes: Extensive Exploration of Scalable Hardware Systems with CXL-Based Simulation Framework 给出的不是一套已落地的内存池,而是一个 CXL 系统仿真框架。它重点支持较新规范里的 PBR(基于端口的路由)、DMC(设备管理的一致性),以及全双工链路建模,目的是在动手造复杂硬件前先回答设计问题。
从一棵树变成一张图
早期主机—设备连接容易用树表示,但多级交换、对等设备访问不一定适合主机为中心的树状路径。Xerxes 把系统拆成两个层次:互连层把节点和交换机组织成图,提供路由与链路队列;设备层把主机、加速器和内存端点抽象成可以主动发请求的参与者。交换机、请求者、内存设备可以分别实现自己的逻辑,拓扑变化不必重写设备模型。
互连图:主机/加速器 ─ 交换机 ─ 交换机 ─ 内存端点
            │                    │
            └─ PBR 决定转发路径 ─┘

设备层:请求者维护本地缓存状态
        内存端点跟踪共享者、必要时主动发失效消息
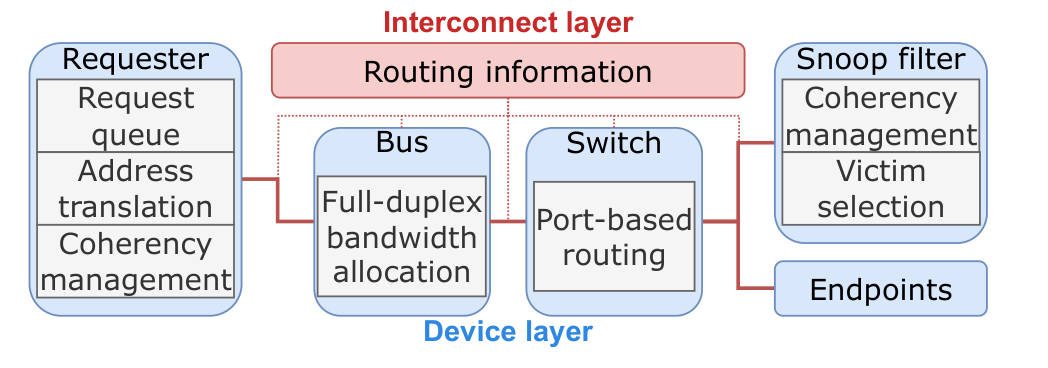
论文图 3:互连层负责路由和链路,设备层模拟请求者、端点及一致性目录。截图来自 Xerxes 官方 PDF 第 6 页,版权归原作者。
因此它不仅能画出链、树、环、spine-leaf 和全连接拓扑,还能在这些结构上模拟设备之间的流量会在哪个端口排队。高连接度不是免费的,但至少可以先用统一的链路参数,把单个中心端口到底限制了多少吞吐量量出来。
模拟里一个“请求者”除了发读写,还要带着排队深度、地址交错规则和本地缓存的一致性状态;链路也不能只填一个固定 RTT。Xerxes 可以接入 DRAMsim3 模拟内存端点,并与 gem5 的处理器、SimpleSSD 的设备模型对接。独立互连层的意义就在这里:换一种存储设备或 CPU 模型,不应被迫再写一套交换机路由逻辑。
在相同端口上限、N 个请求者与 N 个内存设备的构造实验里,链与树的共享“桥”路径会被单端口带宽锁住;环提供替代路径,但总容量仍有限。全连接允许更多请求者并行获得各自的端口带宽,spine-leaf 则居中折中连接密度与路径数量。论文先分析这个受端口限制的结构性上界,再回放应用访问轨迹;如果只挑“3.63 倍”这个数字,就看不到为什么对某种热图有用、对另一个成本预算可能不合适。
DMC 为什么需要“设备会主动说话”
共享内存的一致性,不只是“大家都能读到同一个地址”。某个请求者缓存了一个内存行,另一个请求者要修改它时,原来的副本需要失效;若它是脏的,还涉及最新数据的回传。在 DMC 模型里,设备侧的 snoop filter 记录谁持有这些副本,发出反向失效请求(BISnp),收齐响应(BIRsp)之后才能继续。若 snoop filter 已满,逐出一个目录项也可能触发失效。
这就是传统“设备只被动应答”的模拟器难以涵盖的地方:一次页表外的远端访存,还可能消耗若干控制消息、链路时间和等待时间。Xerxes 把 snoop filter 的条目、受害者选择和消息路径放进模型,才有条件问:换一种目录项淘汰策略,性能会变多少?
可以把 snoop filter 想成一张“谁在本地持有哪行缓存”的小目录。假设请求者的本地缓存早已接住热门数据,真正到达内存设备的请求大多是冷数据未命中:此时目录刚刚插入的记录更可能指向冷行,先逐出它比机械地逐出最老记录,更不容易向热门行的持有者发送昂贵的 BISnp。论文的 LIFO 优势正发生在90% 请求访问热点、请求者本地缓存先过滤热点的特定模拟配置里,绝不是数据库缓存都该放弃 LRU 的证据。
三组结果,回答三类设计问题
作者一方面用真实 CXL 设备校准基础模型,一方面在仿真中探索当前难以搭建的大拓扑。下表中的倍数与误差来自不同实验,不要拼成某套机器的完整基准分数:
| 问题 | 论文里的观察 | 必须记住的条件 |
|---|---|---|
| 多设备拓扑如何影响吞吐 | 轨迹回放中,环相对瓶颈拓扑最高约 1.72 倍;spine-leaf/全连接最高约 3.63 倍 | 链、树的共享路径受单端口限制;路由、端口带宽按仿真设置,不含部署成本结论 |
| 设备侧 snoop filter 该淘汰谁 | 热点集中负载里,LIFO 对比 FIFO:带宽约增 5%,平均延迟约降 15%,失效次数约降 16% | 请求者本地缓存先过滤大量热访问,设备侧看见的流量分布不同,非通用 LIFO 优势 |
| 全双工理论上能挣多少 | 无协议头开销、读写各半时,聚合带宽可接近只读场景的两倍 | 头部占比提高,收益下降;头与载荷等长时论文设置下收益接近零 |
还有个有趣的反例:协议允许一次反向失效带走相邻多条 cache line(InvBlk),直觉上“每次失效越多越好”。作者的测试却发现,长度为 2 带来的等待时间改善最划算;再增加长度,请求者查询本地缓存和链路传输的成本开始抵消收益。协议提供能力,不代表参数应该取最大值。
全双工也是同一个道理。纯读时一侧链路方向忙,另一方向可能用不上;读写各半时,两个方向才能更充分地并行传输。但消息除了载荷还包含协议头:如果头的字节数越来越大,平均一份业务数据花在链路上的时间更多,双向同时跑的收益会被抵消。Xerxes 把读写比例、包头占比设为独立变量,是在问“何时值得在硬件设计里为全双工付成本”,而不是宣布所有混合负载都能白捡两倍带宽。
哪些结果被硬件验证了,哪些仍是推演
论文拿一套CXL 2.0 内存扩展设备进行校准,在受测加载延迟—带宽曲线上,仿真与硬件的平均误差约 4.3%。软件还能与 gem5、DRAMsim3 等模型结合。较新的 PBR 多跳与 DMC 反向失效功能,主要通过理论时序或构造工作负载检查,而不是已经搭建 CXL 3.1 多级交换机机柜之后量出上述吞吐倍数。
这几类“误差”尤其不能混淆:4.3% 来自真实 CXL 2.0 硬件的加载延迟曲线;论文对新特性的检查,则报告 PBR 不同跳数相对理论模型的平均延迟误差约 10.4%,一类 DMC 脏写反向失效往返约 1.4%。后两个数字说明内部时序模型与推导相符,不是用尚未出现于该测试台的多交换机真机做出的外部校准。论文的 SPEC CPU2017 对照也特意比较 CXL 额外带来的执行时间开销,而非宣称准确预测任意处理器的完整运行时间。
这条边界很重要:Xerxes 能帮助识别树形瓶颈、链路协议开销和设备侧目录策略的影响,但仿真中密拓扑最优,不等于真实采购、功耗、扩展性维护也最优。拿它探索设计空间是合适的;拿模型倍数直接给生产硬件排期,就跨过了论文提供的证据。